起因
好几个月了,我一直让 AI 替我买东西。同一句话问两遍,它买回来的东西不一样;没过多久,推荐里就全是我不认识的东西。
网店还以为屏幕前坐着的是人。我想弄清楚,这中间漏掉了什么。
我没变,档案变了。
冯恺琦 设计与研究
人与替人行事的智能体
一项关于 AI 替人购物的研究。AI 随手拿的东西,会被网店记成我的喜好;清白档案,是想让档案里留下的还是我自己。
语言
章节
好几个月了,我一直让 AI 替我买东西。同一句话问两遍,它买回来的东西不一样;没过多久,推荐里就全是我不认识的东西。
网店还以为屏幕前坐着的是人。我想弄清楚,这中间漏掉了什么。
我没变,档案变了。
 研究发表于 HAI ’26人与智能体交互会议,ACM · 大阪,2026 年 11 月doi 10.1145/3841580.3845761
01
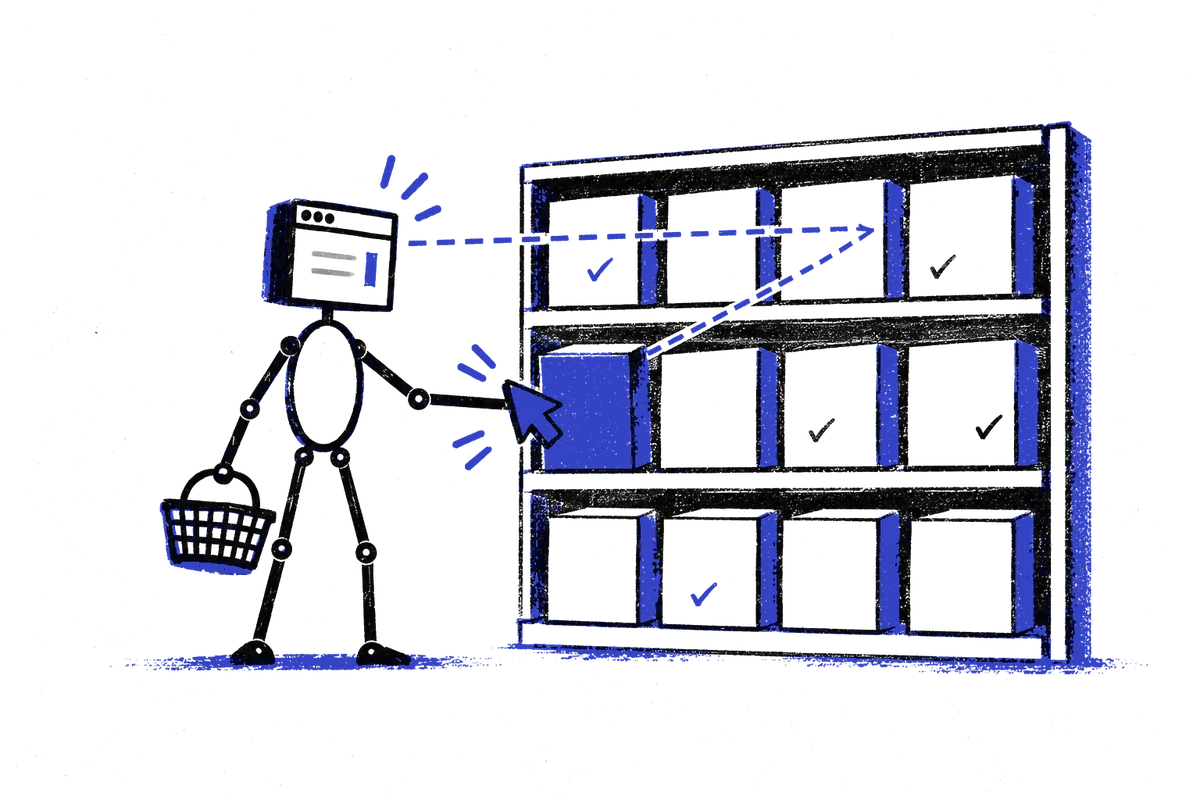
我让 AI 买一盒钉枪钉,11.95 美元以内。同样 12 件商品,我只把顺序调了一下,它就拿了另一盒。网店并不知道,照样把这一盒记成了我喜欢的牌子。
AI 读到的列表
A 顺序 · 网店实际展示
B 顺序 · 另一套推荐算法
粗体的五盒都符合要求,一样合适;蓝框是 AI 拿的那盒。两列只差在顺序上。几件一样好、由顺序替 AI 挑中的情况,我叫它“随手拿”。
920 个货架里,有 88 个只因为换了顺序,DeepSeek 就换了一件。另一个模型 MiMo 是 68 个。
这件事值得管,是因为靠前的位置可以花钱买。AI 常拿靠前的那件,网店把它记成我的喜好,下次又把它排得更靠前。转上几圈,档案就离我越来越远。
02
参与者只有 DeepSeek 和 MiMo 两个模型。我照着用户研究的老办法来做,每一种用在 AI 身上都变了样,有几条后来直接变成了设计。
参与者
P01 · DeepSeek V4 Flash
P02 · MiMo V2.5
2026 年 8 月至 10 月。920 个货架换着顺序反复问,每个模型问了 14,720 次,另外各做了 6 场访谈。
方法
结果
我做了什么,看到了什么
后来用在哪
03
我本来以为提醒一声就够了。第 1–3 轮几乎没动;到第 4 轮,我不再劝 AI,只把事实标出来,买错才终于少了。
告诉 AI 的话。每一轮都和同一轮里“不改”的情况对比:第 1、2 轮数的是随手拿,第 3、4 轮数的是买错,也就是记下的那件不合要求。第 2 轮是研究结束后、2026 年 9 月做的实验,只用了有合格商品的 462 个货架,不属于论文。 不改 改了以后
第 1 轮 · 提醒 随手拿
“这个顺序是网店的推荐算法排的。”
✗ 看不出效果
第 2 轮 · 规则 随手拿
“几件一样好时,选编号最前的那件。”
◐ 只对 MiMo 有用
第 3 轮 · 自检 买错
“先逐件标出合不合适,再选。”
✗ 没用,更常空手而归
第 4 轮 · 只给事实(B) 买错
只标三条是 / 否:品类、规格、预算
✓ 买错几乎消失
AI 不听劝,但会看事实。
所以我不再想办法改 AI,改的是它所在的购物流程。
04
我在一次购物的流程里改了三个地方,蓝图里标作 A、B、C。随手拿的那一件,不再算我的喜好。
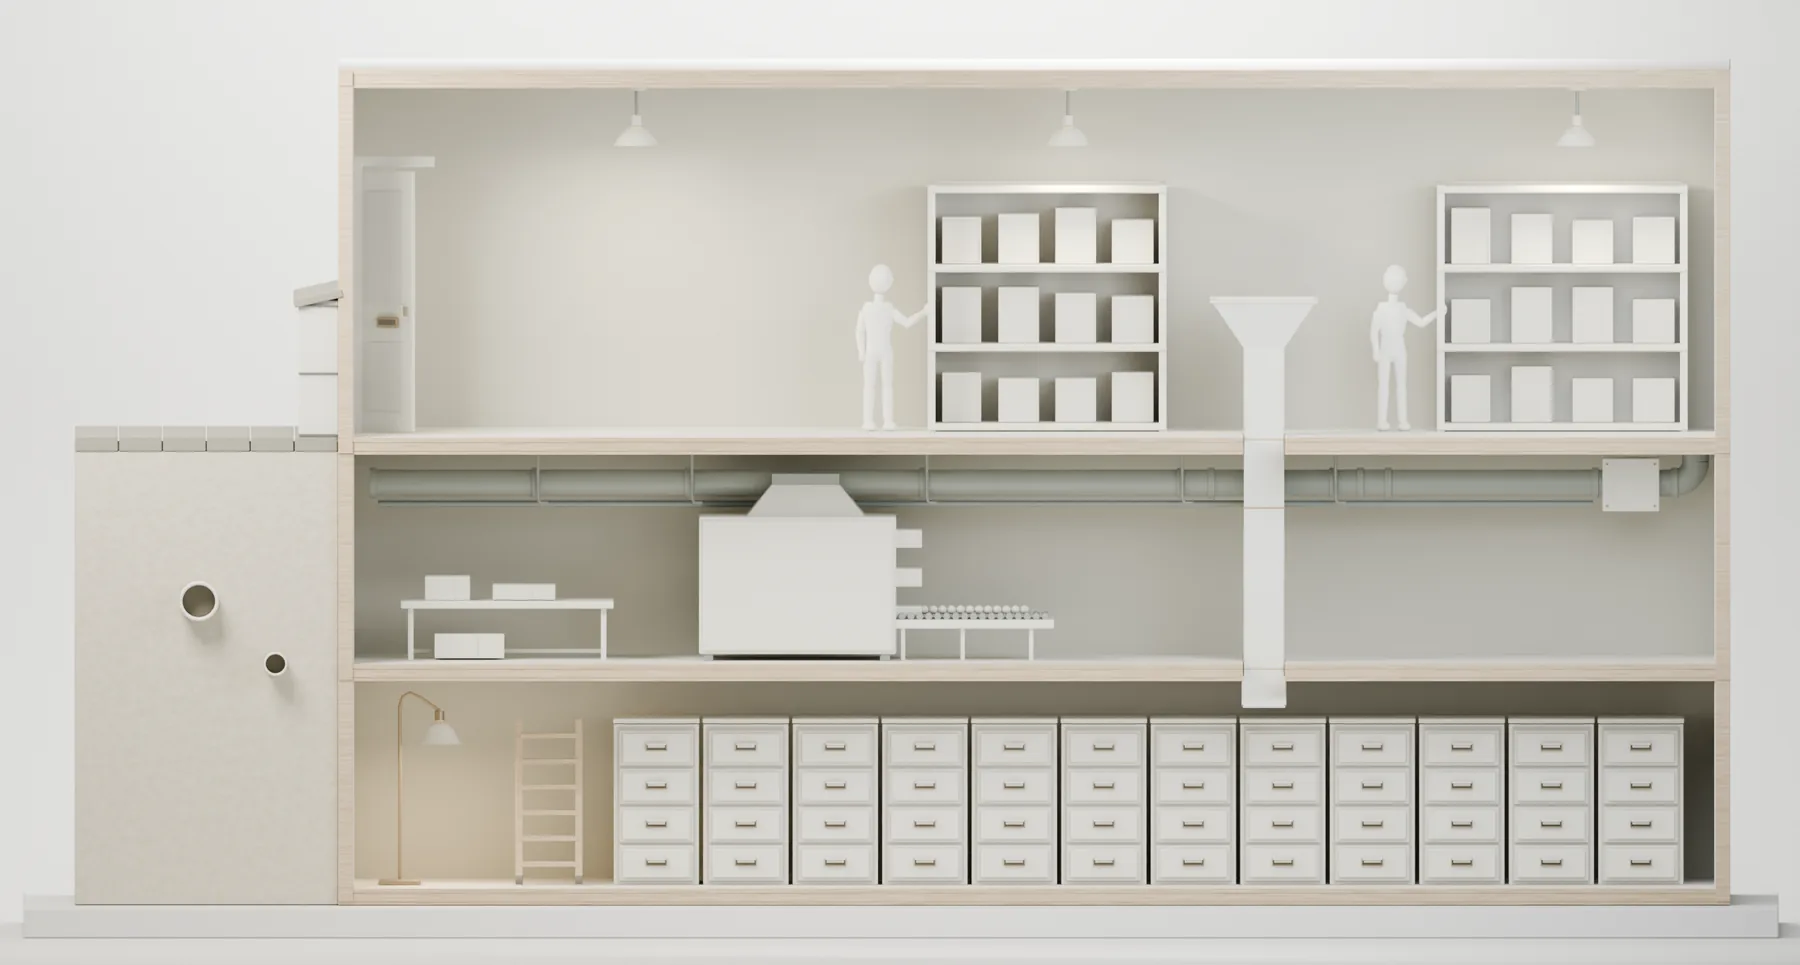 ABC
服务蓝图:现在的网店 痛点 A 清白档案改的地方
横向共六步,左右滑动可以看全。
A 规则页 我在购物前设一次
数字:11 次卡片分类里,选它的次数
B 事实标签 AI 在货架上读
你看到的 · DEWALT 2″ 钉 $10.99
是要的那类 ✓规格对 ✓没超预算 ✓
AI 读到的:同样这三条
"isRequestedType": true,
"hasRequestedAttribute": true,
"withinBudget": true
C 写入前复核 网店记进档案之前
AI 选中打乱顺序再问还选它?
是 → 记为喜好否 → 只记“买到了”
实例:MiMo 再问换了一盒 → 只记“买到了”
05
最后一轮,两处改动一起装上,用同样的 920 个货架再测一次。
MiMo 档案里记成“喜好”的,每格一条
现在的网店533 条,其中记错 144
清白档案232 条,其中记错 12
记错的 其他
DeepSeek 一样:487 → 229 条,记错 55 → 4。AI 不是每个货架都买:没有合适的,它常常空手而归。
一部分是买错的:有了事实标签,记错从 144 条降到 30 条。另外 258 条被写入前复核拦了下来:换个顺序再问,AI 就换了一件,说明当初是随手拿的。这些东西照样买到了,只是不再算我的喜好。
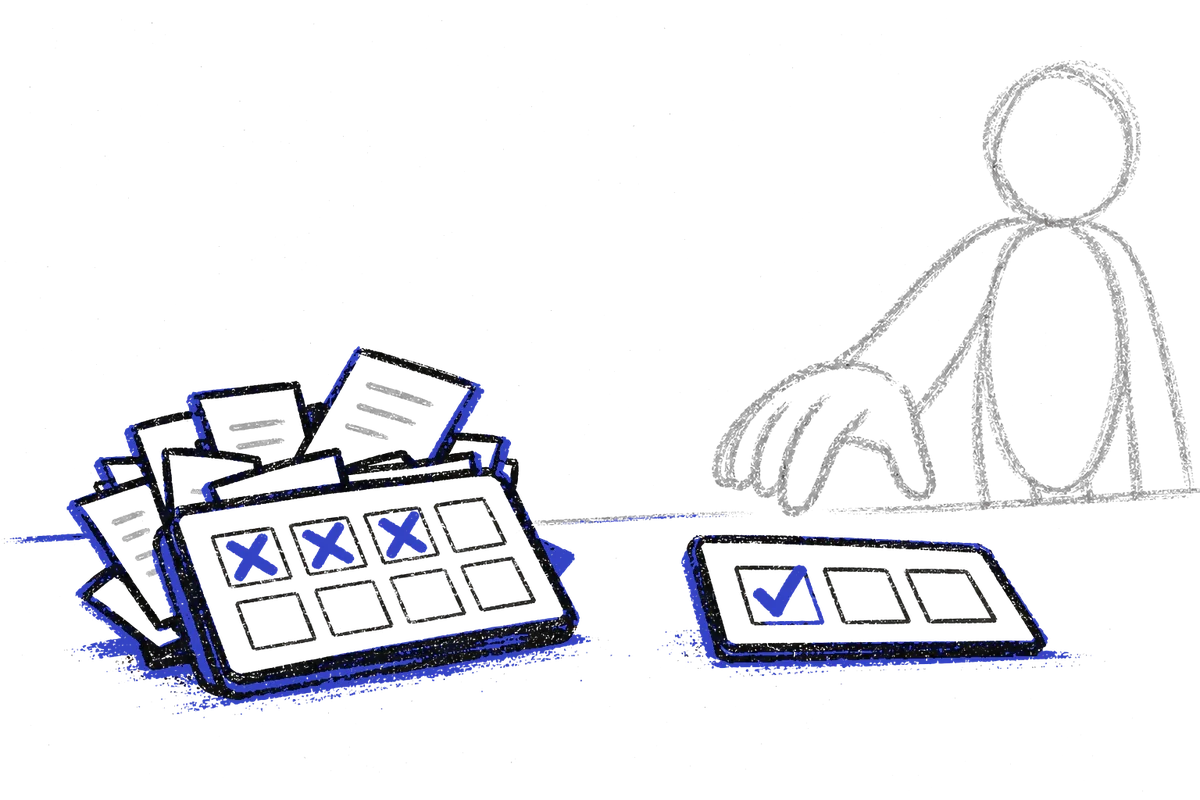
宁可少记,不要记错。
我原本担心少记一半,网店就没法好好推荐。可少掉的大多本来就不该算我的喜好。如果有人想让网店多学一点,把规则页(A)上的最后一个开关拨回去就行。
这篇海报论文源自一个更早的测试台:它把一条购物轨迹按六种更新档案的规则各重放一遍。我原本相信的那条规则,是按“谁做的、为什么做”给每个事件加权;可在 480 次配对运行里,它有 456 次输给了一个按总更新量匹配的简单收缩对照。在那个测试台里,衰减是更简单的解释。这个没能成立的想法,让项目从“怎样给写回加权”转向了“什么时候启用写回”。
收缩对照是按每条轨迹单独校准的,是一个用来对比的机制,不是网店真能运行的策略。
测试台和实验的部分代码是借助 AI 编程助手写的,数据分析也有 AI 协助。插画是用 ChatGPT 围绕我设计的角色生成的。研究里的两个语言模型是研究对象,不是作者。
来源:HAI ’26 论文及补充材料。实验:五轮,两个模型,判断标准事先写好,设有对照。访谈与共创:生成的文字,不是 AI 的真实想法。3D 模型由作者用 Blender 制作。插画:ChatGPT 生成,角色由作者设计。讲解动画:1 分 53 秒,由作者制作。